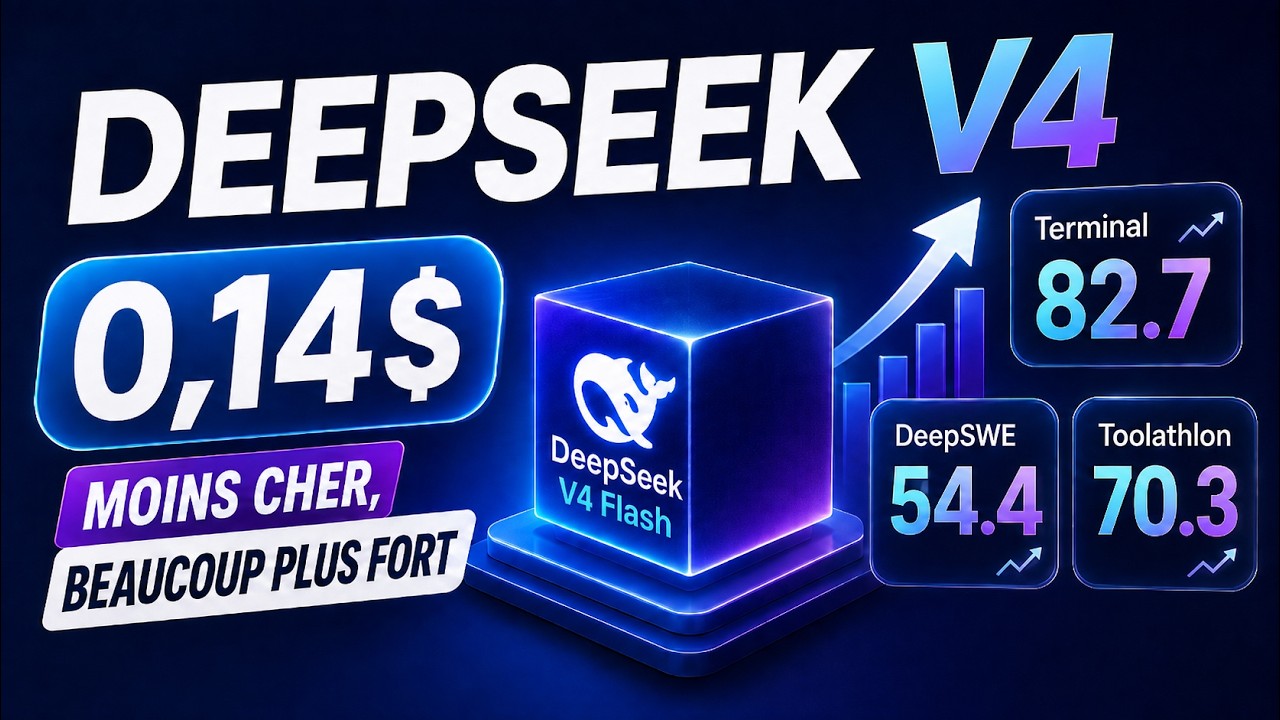
Pourquoi DeepSeek V4 Flash 0731 change ABSOLUMENT TOUT ?
Historique des titres
- Pourquoi DeepSeek V4 Flash 0731 change ABSOLUMENT TOUT ? — observé le 20261110-0253 UTC (YouTube)
Mots-clés
Résumé
142 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La vidéo apporte une information récente et chiffrée sur un modèle IA spécifique. Le créateur s’appuie sur trois benchmarks reconnus et présente des résultats concrets. Il argumente de manière structurée en montrant l’importance du post-training pour les tâches agentiques, et illustre son propos par un test pratique avec OpenCode. Les chiffres de prix sont clairs et permettent d’évaluer l’intérêt économique. Cependant, l’argumentation repose uniquement sur des déclarations sans vérification indépendante, et le test pratique est de nature anecdotique (résultat sommaire). La démonstration est néanmoins convaincante sur le rapport coût/performance.
Rigueur scientifique, qualité des sources, adéquation du titre
Le créateur ne fournit pas de sources écrites (liens vers les benchmarks) dans la description, ce qui limite la vérifiabilité des chiffres. Il mentionne les noms des benchmarks mais sans références directes. Le titre est accrocheur et exagéré, mais le contenu est plus nuancé : le créateur reconnaît que le modèle n’est pas meilleur que les modèles plus chers mais offre un bon rapport qualité-prix. L’adéquation est correcte, bien que le titre soit hyperbolique. La rigueur scientifique est donc moyenne, les chiffres étant présentés sans source primaire.
191 mots
Adéquation titre / contenu
Le titre est accrocheur et exagéré, mais le contenu reste honnête en présentant des améliorations réelles avec des nuances.
Qualité & fiabilité
6/10
Les chiffres des benchmarks sont présentés sans sources primaires vérifiables, mais le contenu est cohérent et le test pratique est concret. Le créateur nuance ses affirmations.
Chapitres
- DeepSeek V4 Flash : des performances qui explosent
- Pourquoi DeepSeek V4 Flash est beaucoup plus performant
- Les benchmarks agents IA : DeepSWE, Terminal Bench et Toolathlon
- Le vrai game changer : son prix
- Test réel avec OpenCode : création d’un clone de NotebookLM
- Premier résultat : une application pour seulement 10 centimes
- Amélioration de l’application avec DeepSeek V4 Flash
- Résultat final et bilan
Sources citées
- Pentiminax | Site de l'auteur — Site personnel mentionné dans la description de la vidéo.
Sources concordantes
- DeepSeek – Site officiel — Source officielle des modèles DeepSeek évoqués dans la vidéo.
Références externes
Apport & nouveautés
La vidéo met en lumière une évolution récente de DeepSeek avec des chiffres de benchmarks actualisés, ainsi qu’une démonstration pratique du coût très faible des agents IA. L’apport original réside dans ce test réel et l’accent mis sur le prix comme facteur clé pour le développement agentique.
Pour aller plus loin :
- Modèle de langage — Pour comprendre les bases des LLM.
- Agent intelligent — Concepts des systèmes autonomes.
- Benchmark (informatique) — Méthodologie des évaluations de performance.
- DeepSeek — Site officiel du modèle.
83 mots
Profil radar
Le profil est équilibré avec des scores moyens en quantité et qualité d'information, un niveau technique conséquent et une fiabilité modérée, indiquant une vidéo utile mais à prendre avec recul.